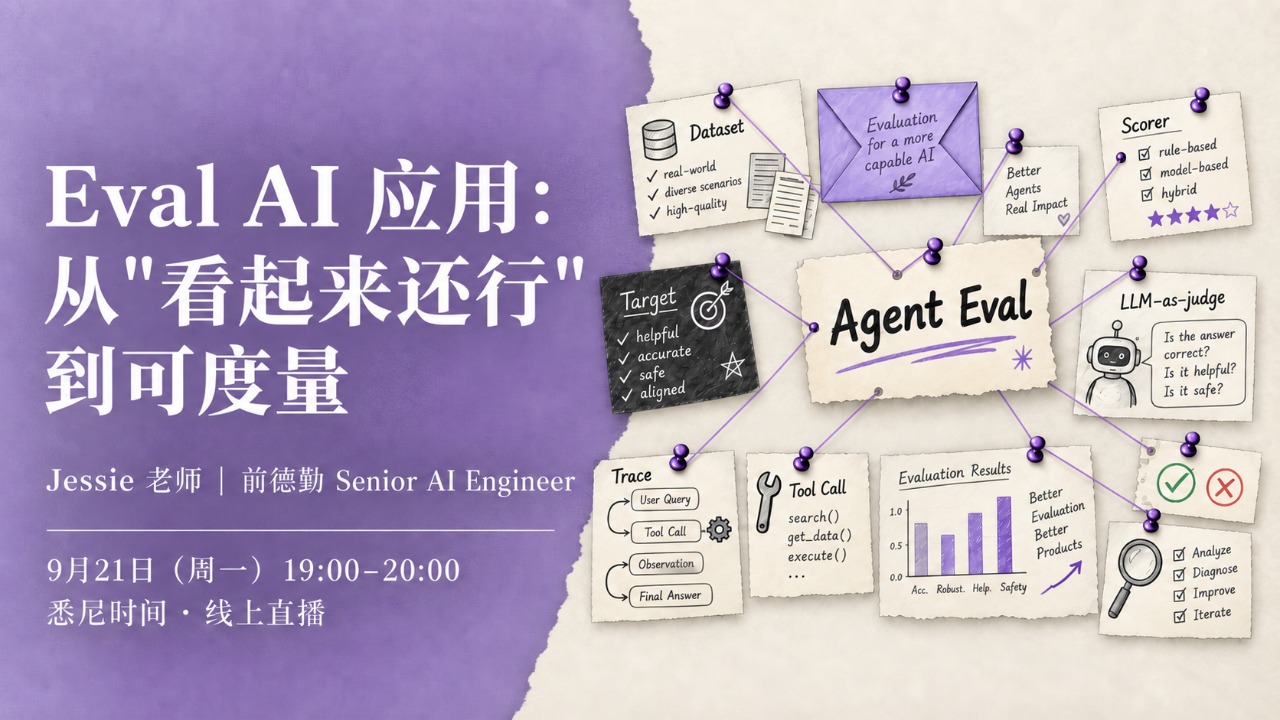
答案对了,Agent 就算成功了吗?
一个 Agent 最终给出了正确答案,但执行过程中调错了工具、绕了 20 步,还发生了越权调用。如果只看最后的输出,这次运行可以拿到满分;但从可靠性、效率和权限边界来看,它显然存在问题。
这也是 AI 应用走向生产时经常遇到的难题:Demo 看起来不错,几个测试问题都能答对,却很难说清楚它在什么条件下可靠、哪里容易失败,以及每一次修改是否真正提升了质量。
改完 Prompt、换了模型、调整了工具调用逻辑之后,如何区分「改好了」和「换了一组还没测到的失败」?当应用表现不稳定时,又该从哪里开始排查?
本次活动由 前德勤 Senior AI Engineer Jessie 老师主讲,从一段真实的 Agent 执行记录出发,围绕评估设计、失败诊断、AI 评委校准和工程落地,系统讲解如何建立一套可度量、可诊断、能持续迭代的 AI 应用评估机制。
活动时间: 2026 年 9 月 21 日(周一),悉尼时间 19:00–20:00
活动形式: 线上直播
主讲人: Jessie 老师|前德勤 Senior AI Engineer
互动环节: 10 分钟 Q&A
在 AI 应用开发中,生成一个看起来合理的回答,往往只是开始。真正进入业务流程后,还需要回答更具体的问题:
同一类任务换一种表达,应用还能稳定完成吗?
最终答案正确,是否意味着工具选择、调用参数和执行过程都合理?
某个组件表现变差,是否一定会影响整体任务成功率?
用另一个大模型来打分,它的判断值得信任吗?
发版前通过的测试,能否覆盖上线后不断变化的真实需求?
Eval 的价值,就在于把这些问题转化为明确的测试案例、判断标准和反馈信号,让团队能够有依据地比较版本、定位问题,并决定下一步该改什么。
一、从一个「答对了的失败案例」开始
通过一段真实 trace,观察 Agent 如何在给出正确答案的同时,暴露工具误用、冗长执行和越权调用等问题,理解为什么只看最终输出还不够。
二、拆解 Eval 的基本构成
围绕 Dataset、Scorer 和 Target,讲清测什么、怎么判分、评估谁。理解离线评估与在线评估的分工,以及如何在输入、规划、工具调用和输出各环节设置检查。
三、建立 Agent 评估的三个层次
从结果、轨迹和组件三个层次评估 Agent,理解它们如何互相掩盖问题。结合失败诊断思路,定位工具选错、参数错误、结果未被采用和规划失误等原因。
四、LLM-as-judge:先评估负责打分的评委
认识 AI 评委的位置、长度和自我偏好,理解「评分一致」为什么不等于「判断正确」。学习如何拆解评分标准,用人工确认的校准集和定期抽检验证 judge 的可靠性。
五、一周内,搭起第一版评估流程
从 10–20 个关键案例起步,将评估接入 CI,再从生产 trace 中持续补充真实失败。结合生产环境中的两层 eval pipeline,讨论具体落地方式与数据集建设的真实成本。
六、谁来定义「好」?
明确业务专家与工程团队的分工:业务定义评分标准,工程搭建评估系统。通过判分抽检、标准更新和数据集维护,让评估持续贴近业务需求。
评估设计框架: 把「感觉不错」拆成具体、可检验的质量标准。
失败诊断方法: 从最终输出追溯执行过程,更有条理地定位问题。
AI 评委校准思路: 识别 judge 的局限,建立人工校准与复检机制。
第一版落地路径: 从少量关键案例开始,将评估逐步接入 CI 和生产反馈。
协作分工参考: 明确业务专家与工程团队如何共同维护评估质量。
正在开发或上线 AI 应用、RAG、Agent 的工程师与技术负责人
负责 AI 产品迭代、质量评估和上线验收的产品经理
需要把业务经验转化为评估标准的领域专家
已经做出 Demo,希望进一步建立系统评估流程的开发者
活动设有 10 分钟 Q&A。欢迎带着正在遇到的具体问题参加:测试案例如何选、工具调用如何评估、judge 判分不稳定怎么办,以及如何为现有应用迈出评估落地的第一步。
9 月 21 日(周一)悉尼时间晚 7 点,线上见。
答案对了,Agent 就算成功了吗?前德勤 Senior AI Engineer Jessie 老师将从真实执行案例出发,拆解 AI 应用的评估设计、失败诊断、LLM-as-judge 校准与生产落地,分享从 10–20 个关键案例启动第一…
答案对了,Agent 就算成功了吗?
一个 Agent 最终给出了正确答案,但执行过程中调错了工具、绕了 20 步,还发生了越权调用。如果只看最后的输出,这次运行可以拿到满分;但从可靠性、效率和权限边界来看,它显然存在问题。
这也是 AI 应用走向生产时经常遇到的难题:Demo 看起来不错,几个测试问题都能答对,却很难说清楚它在什么条件下可靠、哪里容易失败,以及每一次修改是否真正提升了质量。
改完 Prompt、换了模型、调整了工具调用逻辑之后,如何区分「改好了」和「换了一组还没测到的失败」?当应用表现不稳定时,又该从哪里开始排查?
本次活动由 前德勤 Senior AI Engineer Jessie 老师主讲,从一段真实的 Agent 执行记录出发,围绕评估设计、失败诊断、AI 评委校准和工程落地,系统讲解如何建立一套可度量、可诊断、能持续迭代的 AI 应用评估机制。
活动时间: 2026 年 9 月 21 日(周一),悉尼时间 19:00–20:00
活动形式: 线上直播
主讲人: Jessie 老师|前德勤 Senior AI Engineer
互动环节: 10 分钟 Q&A
在 AI 应用开发中,生成一个看起来合理的回答,往往只是开始。真正进入业务流程后,还需要回答更具体的问题:
同一类任务换一种表达,应用还能稳定完成吗?
最终答案正确,是否意味着工具选择、调用参数和执行过程都合理?
某个组件表现变差,是否一定会影响整体任务成功率?
用另一个大模型来打分,它的判断值得信任吗?
发版前通过的测试,能否覆盖上线后不断变化的真实需求?
Eval 的价值,就在于把这些问题转化为明确的测试案例、判断标准和反馈信号,让团队能够有依据地比较版本、定位问题,并决定下一步该改什么。
一、从一个「答对了的失败案例」开始
通过一段真实 trace,观察 Agent 如何在给出正确答案的同时,暴露工具误用、冗长执行和越权调用等问题,理解为什么只看最终输出还不够。
二、拆解 Eval 的基本构成
围绕 Dataset、Scorer 和 Target,讲清测什么、怎么判分、评估谁。理解离线评估与在线评估的分工,以及如何在输入、规划、工具调用和输出各环节设置检查。
三、建立 Agent 评估的三个层次
从结果、轨迹和组件三个层次评估 Agent,理解它们如何互相掩盖问题。结合失败诊断思路,定位工具选错、参数错误、结果未被采用和规划失误等原因。
四、LLM-as-judge:先评估负责打分的评委
认识 AI 评委的位置、长度和自我偏好,理解「评分一致」为什么不等于「判断正确」。学习如何拆解评分标准,用人工确认的校准集和定期抽检验证 judge 的可靠性。
五、一周内,搭起第一版评估流程
从 10–20 个关键案例起步,将评估接入 CI,再从生产 trace 中持续补充真实失败。结合生产环境中的两层 eval pipeline,讨论具体落地方式与数据集建设的真实成本。
六、谁来定义「好」?
明确业务专家与工程团队的分工:业务定义评分标准,工程搭建评估系统。通过判分抽检、标准更新和数据集维护,让评估持续贴近业务需求。
评估设计框架: 把「感觉不错」拆成具体、可检验的质量标准。
失败诊断方法: 从最终输出追溯执行过程,更有条理地定位问题。
AI 评委校准思路: 识别 judge 的局限,建立人工校准与复检机制。
第一版落地路径: 从少量关键案例开始,将评估逐步接入 CI 和生产反馈。
协作分工参考: 明确业务专家与工程团队如何共同维护评估质量。
正在开发或上线 AI 应用、RAG、Agent 的工程师与技术负责人
负责 AI 产品迭代、质量评估和上线验收的产品经理
需要把业务经验转化为评估标准的领域专家
已经做出 Demo,希望进一步建立系统评估流程的开发者
活动设有 10 分钟 Q&A。欢迎带着正在遇到的具体问题参加:测试案例如何选、工具调用如何评估、judge 判分不稳定怎么办,以及如何为现有应用迈出评估落地的第一步。
9 月 21 日(周一)悉尼时间晚 7 点,线上见。
获取最新 AI 活动 / Workshop / Meetup 通知,邮箱可随时退订。
按城市、方向和活动类型找下一场 Workshop、Meetup 或直播。


我们很自豪能够与一些全球最具影响力的科技和商业公司建立合作。这些合作伙伴关系展现了我们对卓越与创新的承诺,并为我们的学员提供了接触Professional Networking, 真实项目, 实习机会, 就业机会以及前沿技术的宝贵机会。